研究
研究の概要
AIが多様な知識を活用するには、知識の性質に応じて、モデルに学習させる、必要なときに外部から調べる、変化に合わせて更新するといった適切な方法を組み合わせる必要があります。
本研究室では、多様な知識を柔軟に扱う大規模言語モデル(LLM)と、必要な情報を自ら探索・統合する検索エージェントを研究しています。これらの研究を通じて、知識に基づいて推論・計画し、自律的に行動するAIの実現を目指しています。
検索エージェント
ウェブや学術文献、組織内の文書など、多様な情報源を活用し、検索と推論を自律的に繰り返す検索エージェントを研究しています。モデルが持つ知識や検索結果を踏まえて必要な情報を探索し、情報の信頼性や新しさを考慮しながら内容を統合して、根拠に基づいて回答するAIの実現を目指します。
異なる言語の情報や、図表・数式を含む情報の活用に加え、探索の効率化や、能力を測る評価データ・評価手法の構築にも取り組んでいます。また、人の知識や判断を生かし、人とAIが協働して調査や問題解決を進める環境の実現を目指しています。
これまでの主な成果
検索の基盤技術として、メモリ使用量を抑えた検索モデルBPRや、再学習せずに事物に関する知識を追加できる検索モデルKPRを提案しました。また、2025年のNeurIPS MMU-RAGコンペティションでは、検索と推論を繰り返し、複数の情報を統合して詳細な回答を生成する検索エージェントを開発しました。このエージェントはText-to-Textトラック・オープンソース部門の静的評価で優勝しました。
質問応答の評価やコンペティションの運営にも取り組んでいます。国際会議NAACL 2022で開催されたMIAワークショップを山田が共催し、同ワークショップでは16言語を対象とする検索型質問応答のコンペティションが実施されました。また、国際会議ICML 2026で開催されたEMM-QAワークショップでは、山田が共同オーガナイザーを務め、文章と画像を用いるマルチモーダル質問応答のコンペティションの運営にも携わりました。
国際コンペティションでは、これまでに以下の成果を上げています。
-
2025年:NeurIPS MMU-RAGコンペティション
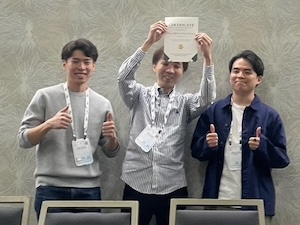
開発した検索エージェントが、Text-to-Textトラック・オープンソース部門の静的評価で優勝しました。
論文:An Open and Reproducible Deep Research Agent for Long-Form Question Answering (Yamada et al., プレプリント、2025年) -
2020年:NeurIPS EfficientQAコンペティション
6GB制約トラックではFacebookに次ぐ2位、無制約トラックではMicrosoftとFacebookに次ぐ3位を獲得しました。
論文:NeurIPS 2020 EfficientQA Competition: Systems, Analyses and Lessons Learned (Min et al., PMLR 2021) -
2017年:NIPS Human-Computer QAコンペティション
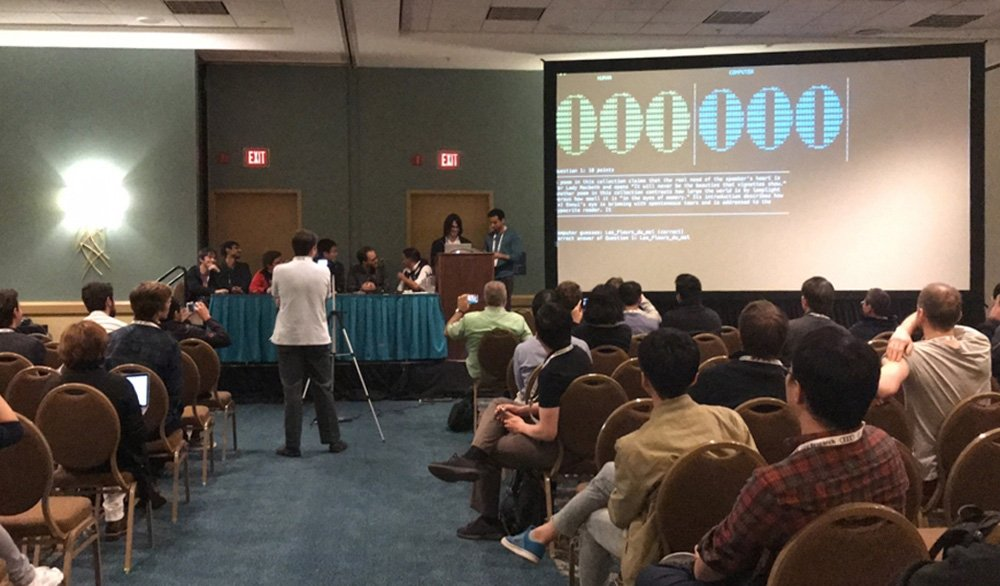
AI同士のコンペティションで優勝し、NIPS 2017のワークショップ会場で行われた全米クイズ王6人のチームとの対戦にも勝利しました。
論文:Studio Ousia’s Quiz Bowl Question Answering System (Yamada et al., The NIPS ’17 Competition: Building Intelligent Systems, 2018)
紹介記事:強すぎて「会場がシーンと……」 クイズ王を圧倒した“早押しAI”の衝撃(ITmedia NEWS)
関連論文
- Dynamic Injection of Entity Knowledge into Dense Retrievers (Yamada et al., Findings of EMNLP 2025)
- MIA 2022 Shared Task: Evaluating Cross-lingual Open-Retrieval Question Answering for 16 Diverse Languages (Asai et al., MIA 2022)
- Efficient Passage Retrieval with Hashing for Open-domain Question Answering (Yamada et al., ACL-IJCNLP 2021)
- Trick Me If You Can: Human-in-the-Loop Generation of Adversarial Examples for Question Answering (Wallace et al., TACL 2019)
大規模言語モデル(LLM)
高度な専門知識、組織や個人に固有の知識、頻繁な更新が必要な知識など、多様な知識を柔軟に扱える大規模言語モデル(LLM)の実現を目指しています。例えば、知識を効率よく学習し、既存の能力を保ちながら更新・訂正する方法や、学習した知識を多様な課題や状況に応じて活用する方法などを研究しています。
また、言語を越えた知識の活用・転移にも取り組んでいます。例えば、ある言語で学んだ知識を別の言語で活用する方法の開発や、言語によって性能に差が生じる要因の分析を進めています。
これまでの主な成果
事物に関する情報を活用する言語モデルLUKE、多言語モデルmLUKE、言語モデルの言語間の知識転移を促すLEIAを提案してきました。LUKEの論文は1,000件以上引用され、モデルはHugging Face Transformersにも収録されています。これらの基盤となる知識表現の研究として、Wikipediaから単語と事物のベクトル表現を学習するWikipedia2Vec、文章と事物を共通のベクトル空間に表すNTEE、事物に関する情報を活用して文の意味表現を学習するEASEなどを開発しました。
関連論文
- LEIA: Facilitating Cross-lingual Knowledge Transfer in Language Models with Entity-based Data Augmentation (Yamada and Ri, Findings of ACL 2024)
- Entity Embedding Completion for Wide-Coverage Entity Disambiguation (Oba et al., Findings of EMNLP 2022)
- A Multilingual Bag-of-Entities Model for Zero-Shot Cross-Lingual Text Classification (Nishikawa et al., CoNLL 2022)
- EASE: Entity-Aware Contrastive Learning of Sentence Embedding (Nishikawa et al., NAACL 2022)
- Global Entity Disambiguation with BERT (Yamada et al., NAACL 2022)
- mLUKE: The Power of Entity Representations in Multilingual Pretrained Language Models (Ri et al., ACL 2022)
- LUKE: Deep Contextualized Entity Representations with Entity-aware Self-attention (Yamada et al., EMNLP 2020)
- Wikipedia2Vec: An Efficient Toolkit for Learning and Visualizing the Embeddings of Words and Entities from Wikipedia (Yamada et al., EMNLP 2020 System Demonstrations)
- Learning Distributed Representations of Texts and Entities from Knowledge Base (Yamada et al., TACL 2017)
- Joint Learning of the Embedding of Words and Entities for Named Entity Disambiguation (Yamada et al., CoNLL 2016)
研究成果の社会実装
研究成果の社会実装を見据え、学術研究や産業分野への応用に取り組んでいます。学術文献の調査や複数の研究の主張・根拠の整理、組織に蓄積された文書や高度な専門知識を活用した技術調査・研究開発などを支えることを目指しています。
また、論文に加えてモデル・コード・評価データの公開を進め、研究成果を広く活用できる形で発信します。学生も研究プロジェクトに参加し、実装・実験・評価から論文発表や成果の公開まで、一連の研究活動に取り組みます。